En résumé. Déployer l'AIOps ne consiste pas à brancher une IA sur tout votre système d'information d'un coup. La démarche qui fonctionne est progressive : un audit de l'existant, un premier cas d'usage ciblé et réversible (souvent la corrélation d'alertes ou le tri des tickets), une mesure des résultats, puis une extension par paliers. Les prérequis sont peu nombreux mais non négociables : des données d'exploitation propres, des actions déclenchables via API, et un historique d'incidents documenté. Sans accompagnement, le risque n'est pas l'échec technique mais l'usine à gaz : un outil sophistiqué que personne n'utilise.
Vous avez compris ce qu'est l'AIOps et vous vous demandez par où l'attaquer. C'est la bonne question, et c'est aussi celle où la plupart des projets dérapent. Pas par manque de technologie : par excès d'ambition au démarrage.
Cet article décrit la méthode que nous appliquons chez IT Systèmes, pensée pour des PME et ETI en environnement Microsoft, pas pour des grandes infrastructures cloud-native. Si votre SI repose sur Microsoft 365, Azure et un parc de postes infogéré plutôt que sur des centaines de microservices Kubernetes, vous êtes exactement la cible de cet article.
La règle de base : on commence petit
C'est le seul vrai conseil qui compte, et tous les déploiements réussis le respectent. On ne déploie jamais l'AIOps en big bang.
La logique est simple. Les modèles d'IA ont besoin d'apprendre le comportement normal de votre système avant de pouvoir repérer ce qui sort de l'ordinaire. Cet apprentissage prend du temps et demande des données. Vouloir tout automatiser dès le premier mois revient à demander à un nouvel arrivant de prendre des décisions critiques sans connaître la maison. Le résultat est prévisible : des faux positifs, une perte de confiance, et un outil qu'on finit par ignorer.
L'approche inverse fonctionne. On choisit un périmètre réduit, non critique, réversible. On mesure. On ajuste. On étend une fois la confiance installée. Chaque palier valide le précédent.
La méthode en 5 étapes
Voici le déroulé que nous suivons sur un projet AIOps. Il n'a rien de propriétaire, c'est la trame que partagent les démarches sérieuses du secteur ; ce qui change, c'est l'adaptation au contexte PME et l'accompagnement humain à chaque palier.
Étape 1 — Audit et diagnostic. On dresse l'état des lieux : quels outils de supervision sont déjà en place, quelles données sont disponibles et dans quel état, quels sont les incidents les plus fréquents, et où se trouve le temps perdu par les équipes. Cette étape conditionne tout le reste. Sans données exploitables en entrée, l'IA produit du bruit, pas des décisions.
Étape 2 — Premier cas d'usage ciblé. On choisit un scénario à fort retour et faible risque. Les deux candidats les plus courants : la corrélation d'alertes (regrouper les centaines d'alertes liées à une même cause pour cesser de noyer les équipes) et le tri automatique des tickets de support. On le déploie sur un périmètre limité, en gardant la possibilité de revenir en arrière.
Étape 3 — Déploiement progressif. On intègre l'outil à l'écosystème existant, sans tout remplacer. Dans un environnement Microsoft, ça veut dire se brancher sur ce qui est déjà là (Microsoft 365, Defender, les outils ITSM) plutôt qu'empiler une nouvelle pile technique parallèle.
Étape 4 — Formation et acculturation. L'IA doit être un outil que les équipes comprennent, pas une boîte noire imposée. On forme les techniciens à lire et challenger les recommandations de la plateforme. C'est aussi le moment d'encadrer les risques : des journaux d'exploitation peuvent contenir des données sensibles (identifiants, adresses IP), et il faut éviter qu'elles partent dans des services externes non maîtrisés.
Étape 5 — Pilotage et itérations. On ajuste les seuils, on enrichit les jeux de données, on étend les cas d'usage validés. L'AIOps n'est pas un projet qu'on livre et qu'on oublie ; c'est une pratique qui s'améliore en continu.
Les prérequis, sans détour
Avant de lancer quoi que ce soit, trois conditions doivent être réunies. Si elles manquent, le projet n'est pas mûr, et un bon conseil consiste à le dire.
Des données exploitables. Logs structurés, métriques historisées, accès aux traces. C'est le carburant. Une IA branchée sur des données incomplètes ou sales ne fait qu'automatiser le désordre.
Des actions déclenchables via API. Pour que l'automatisation des réponses ait un sens, la plateforme doit pouvoir agir : exécuter un script, isoler un poste, relancer un service. Sans API ouvertes sur vos outils, l'AIOps se limite à observer.
Un historique d'incidents documenté. Les modèles apprennent du passé. Plus votre historique d'incidents est riche et propre, plus vite la plateforme devient pertinente.
Il y a un quatrième prérequis, moins technique mais décisif : une volonté réelle dans les équipes. L'AIOps change la façon de travailler. Si elle est perçue comme une menace plutôt que comme un allégement, elle échoue, quelle que soit la qualité de l'outil.
Les premiers cas d'usage qui paient
Pour une PME, certains scénarios offrent un meilleur rapport effort/résultat que d'autres au démarrage.
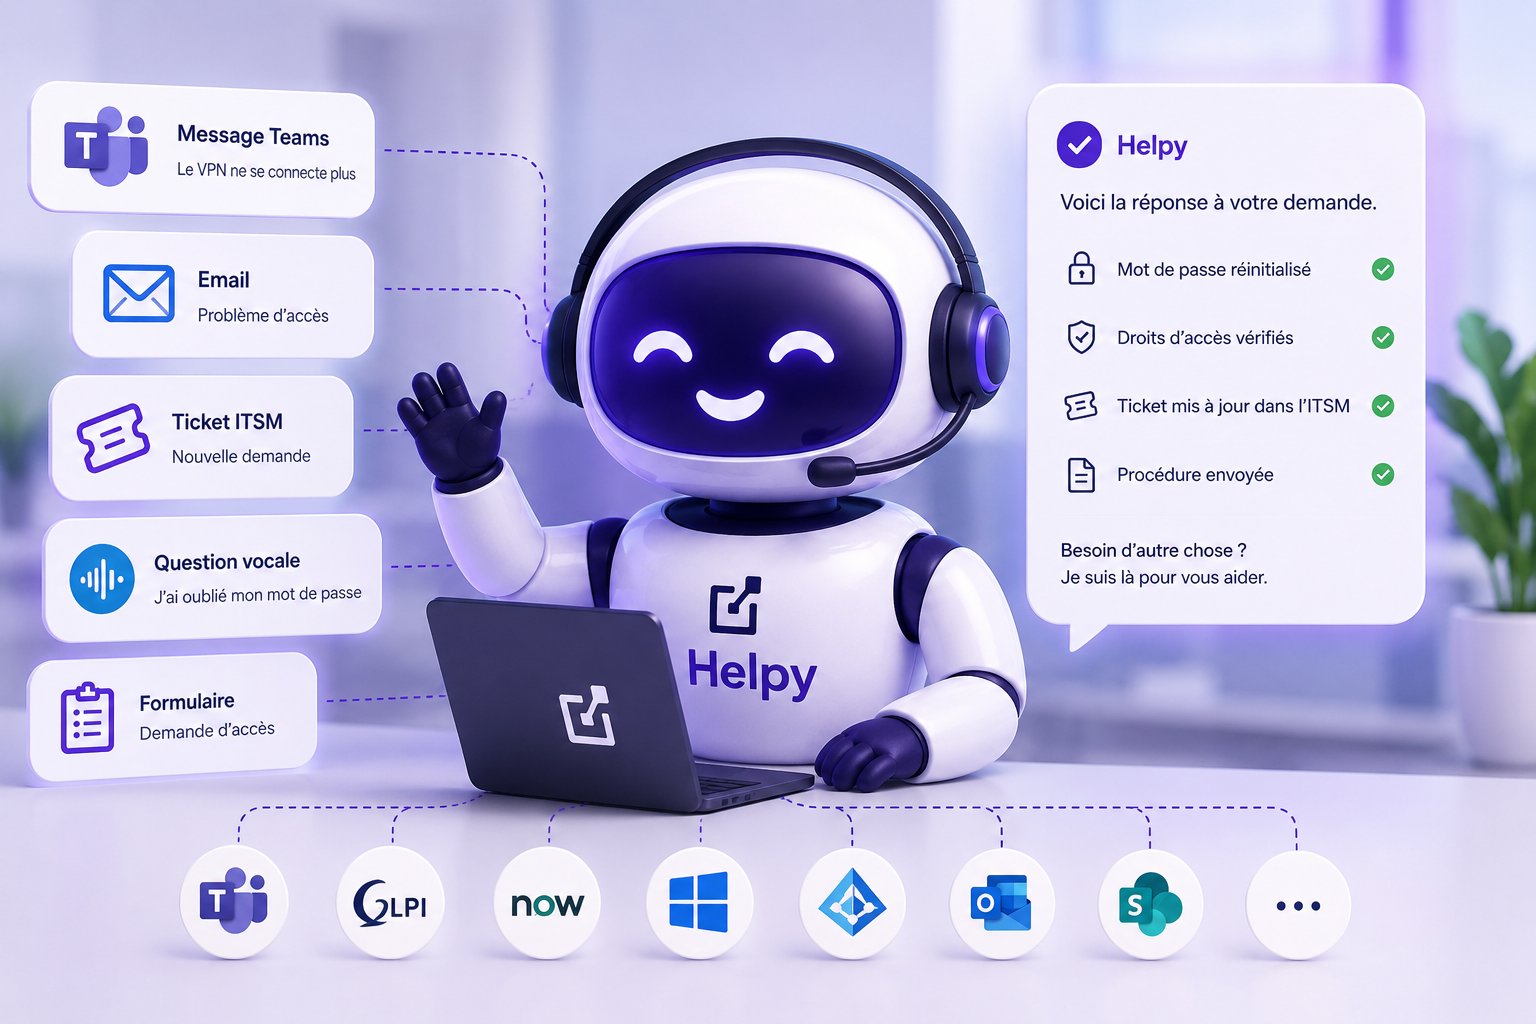
Le tri et la résolution des tickets de niveau 1. C'est souvent le gisement le plus immédiat. Les demandes récurrentes (réinitialisations de mots de passe, problèmes d'accès, questions courantes) représentent une part énorme du volume de support et mobilisent des techniciens sur des tâches sans valeur ajoutée. C'est exactement ce que nous avons automatisé sur notre propre support avec Helpy, notre solution helpdesk augmentée par l'IA : 60 % des tickets de niveau 1 sont désormais résolus en autonomie, avec un délai de réponse passé de plusieurs heures à quelques minutes. On l'a déployée en interne avant de la proposer à nos clients, justement pour valider la méthode sur notre propre terrain.
La corrélation d'alertes. Un même incident génère souvent des dizaines d'alertes dans des outils différents. Les regrouper pour n'afficher que la cause racine réduit le bruit et accélère la résolution. Cas d'usage idéal pour un premier déploiement : fort impact, risque faible, résultat visible vite.
La supervision prédictive. Une fois les bases en place, on passe de la réaction à l'anticipation : repérer les signaux faibles (dérive de latence, saturation qui approche) avant que la panne survienne.
Le rôle d'un partenaire dans la démarche
On peut se demander pourquoi passer par un accompagnement plutôt que de déployer un outil seul. La réponse tient à la nature du sujet.
L'AIOps touche à des données sensibles, à des automatisations qui agissent sur votre production, et à une transformation des habitudes de travail. Les éditeurs de plateformes vendent l'outil ; ils ne portent pas le contexte de votre SI, ne connaissent pas votre historique d'incidents, et ne sont pas là à 3h du matin quand une automatisation se comporte mal. Un partenaire qui opère déjà votre infogérance, lui, part de l'existant et garde la main sur les décisions sensibles.
Chez IT Systèmes, l'AIOps s'inscrit dans notre offre d'infogérance et nos services managés : la supervision IA détecte et corrèle, nos analystes investiguent et tranchent. La machine filtre, l'humain décide. Et comme nous l'utilisons sur notre propre exploitation, on déploie chez vous une méthode qu'on a d'abord éprouvée chez nous.
En bref
Le bon conseil en AIOps tient en une phrase : commencez petit, sur un cas d'usage ciblé et réversible, avec des données propres, et étendez par paliers une fois la confiance installée. Les prérequis (données exploitables, API, historique d'incidents) ne sont pas négociables. Et le principal risque n'est pas technique : c'est de vouloir tout faire d'un coup et de se retrouver avec une usine à gaz que personne n'utilise.
Vous envisagez d'introduire l'AIOps dans votre infogérance et vous voulez savoir si votre SI est prêt ? Parlons-en avec nos experts : notre accompagnement part toujours d'un audit de l'existant, sans engagement.
Questions fréquentes
Par où commencer un projet AIOps ? Par un audit de l'existant, suivi d'un premier cas d'usage ciblé et réversible, le plus souvent la corrélation d'alertes ou le tri automatique des tickets. On mesure les résultats, on ajuste, puis on étend par paliers. Jamais en déploiement global d'un seul coup.
Quels sont les prérequis pour déployer l'AIOps ? Trois conditions techniques : des données d'exploitation propres et exploitables (logs, métriques, traces), des actions déclenchables via API, et un historique d'incidents documenté pour entraîner les modèles. Une quatrième condition, organisationnelle : l'adhésion des équipes.
Combien de temps pour voir des résultats ? Sur un premier cas d'usage bien choisi (corrélation d'alertes, tri de tickets), les premiers effets sont visibles rapidement. La supervision prédictive demande davantage de temps, le temps que les modèles apprennent le comportement normal du système.
Faut-il une grande infrastructure pour l'AIOps ? Non. Le critère n'est pas la taille mais la charge opérationnelle. Dès que le volume d'alertes ou de tickets dépasse ce qu'une équipe traite sereinement, l'AIOps a du sens, y compris sur un environnement Microsoft de PME ou d'ETI.
Peut-on déployer l'AIOps sans partenaire ? Techniquement oui, mais la démarche touche à des données sensibles, à des automatisations qui agissent sur la production et à une transformation des habitudes. Un partenaire qui opère déjà votre infogérance part de l'existant, encadre les risques et garde la main sur les décisions sensibles.